
Le tracking entre dans la chaîne de production logicielle
En Bref
L’idée : transformer le plan de marquage en contrat YAML versionné, intégrer ses contrôles à la CI/CD, automatiser la configuration GTM par API et mobiliser des agents IA pour les tests de non-régression.
Une approche *Tracking-as-Code* où la qualité des données devient un critère de livraison, au même titre que la qualité fonctionnelle ou la sécurité.
Cette évolution pourrait aussi transformer profondément le métier de Digital Analyst, dont les compétences techniques seraient progressivement intégrées aux équipes produit, développement et qualité.
J’explore la faisabilité de ce modèle, ses bénéfices et ses limites. Une réflexion prospective sur l’avenir du digital analytics, entre automatisation, ingénierie logicielle et transformation des métiers.
Avant-propos
Les capacités de l’intelligence artificielle générative sont vertigineuses. Elles ouvrent des perspectives qui invitent à repenser nos pratiques et nos métiers.
Je me suis donc prêté à un exercice prospectif : imaginer ce que pourrait devenir le tracking analytics en associant les pratiques d’ingénierie logicielle, l’automatisation et les capacités émergentes de l’IA.
Cet article présente cette vision, les pistes techniques qu’elle ouvre et les questions qu’elle soulève.
De la mesure déclarative à la mesure vérifiable
Et si la qualité des données devenait un critère de livraison logicielle, au même titre que la qualité fonctionnelle, la sécurité ou la performance ?
Le tracking occupe une place paradoxale dans les projets digitaux. Il constitue un élément essentiel du pilotage de la performance, de la compréhension des comportements utilisateurs et de l’amélioration continue des produits. Pourtant, sa conception, son implémentation et sa validation restent souvent dissociées des processus de développement logiciel.
Les plans de marquage sont généralement formalisés dans des tableurs, des documents de spécifications ou des outils collaboratifs. Leur mise en œuvre dépend ensuite d’interventions successives entre équipes métier, analytics et techniques. La validation intervient fréquemment en fin de cycle, parfois après la mise en production.
Cette organisation crée une fragilité structurelle : une fonctionnalité peut parfaitement fonctionner tout en produisant des données incomplètes, incohérentes ou erronées.
La difficulté s’accentue avec les pratiques modernes de développement. Les déploiements continus, les architectures modulaires, les expérimentations A/B et les mécanismes de feature flipping multiplient les états possibles d’une application.
Un plan de marquage validé à un instant donné peut rapidement perdre sa correspondance avec la réalité fonctionnelle du produit.
L’adoption des pratiques DevOps, l’automatisation des tests, les API de gestion des outils de collecte et l’émergence des agents d’intelligence artificielle permettent aujourd’hui d’envisager une autre approche.
Le tracking doit devenir une exigence vérifiable de la livraison logicielle.
Cette transformation suppose de faire du plan de marquage un contrat technique versionné, testable et intégré aux processus de développement, jusqu’à envisager l’automatisation de la configuration des outils de collecte.
Elle pourrait également remettre en question l’organisation des métiers de l’analytics, jusqu’à envisager la disparition progressive du Digital Analyst dans sa fonction technique traditionnelle.
Cette ambition peut emprunter différentes trajectoires. Selon leur organisation, leurs compétences et leurs moyens, certaines équipes privilégieront l’automatisation des contrôles du dataLayer, tandis que d’autres pourront intégrer la configuration des outils de collecte à leur chaîne de livraison logicielle.
L’enjeu est de définir un niveau d’intégration cohérent avec les besoins et les contraintes de chaque organisation, plutôt que d’imposer un modèle technique universel qui, poussé dans son intégralité, ressemble à s’y méprendre à une sacrée usine à gaz. 😀
La chaîne de production du tracking
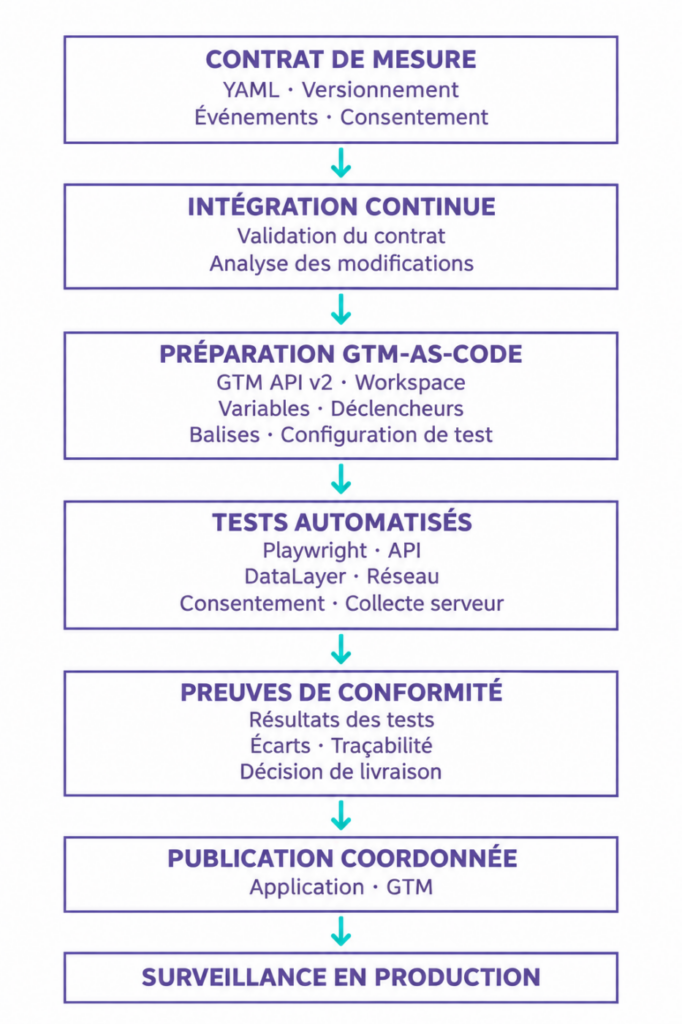
Le principe repose sur une continuité entre les exigences de mesure, leur implémentation, leur validation et leur exploitation.
Le contrat constitue la référence. Les tests et la configuration GTM en sont deux applications complémentaires. La chaîne d’intégration continue coordonne les contrôles et produit les éléments nécessaires à la décision de livraison.
L’ensemble forme une approche de Tracking-as-Code, dans laquelle les exigences de mesure deviennent des composants versionnés et vérifiables du produit logiciel.
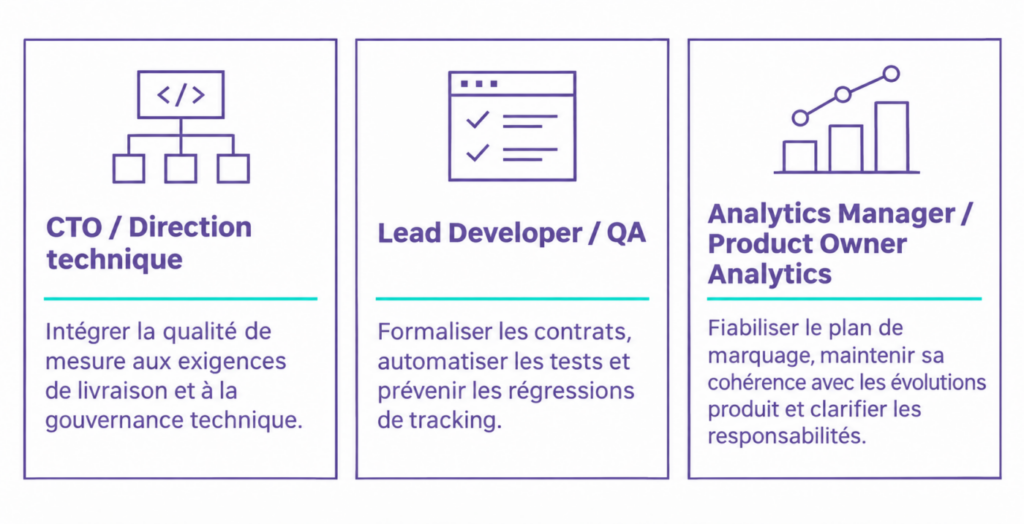
À qui s’adresse cette réflexion ?
1. Faire de la mesure une exigence du produit
Dans une organisation orientée produit, chaque fonctionnalité répond théoriquement à un besoin utilisateur et contribue à un objectif métier.
La mesure de cette contribution devrait être définie dès la conception.
Prenons l’exemple d’une application B2B proposant un formulaire de demande de devis. La fonctionnalité répond à un objectif commercial : générer des opportunités qualifiées.
Son efficacité peut être évaluée à travers plusieurs indicateurs : le nombre de formulaires commencés, le taux d’abandon, le nombre de demandes transmises et le taux de conversion.
Ces indicateurs reposent sur des événements techniques qui doivent être produits par l’application.
La chaîne de conception devient alors :
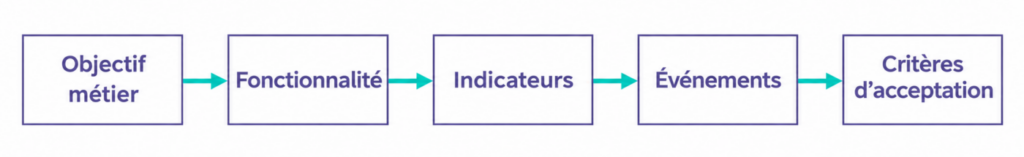
Cette logique rapproche la conception du tracking des pratiques de spécification fonctionnelle.
Une User Story pourrait ainsi comporter deux familles de critères d’acceptation :
– Les critères fonctionnels, qui vérifient le comportement attendu de l’application.
– Les critères de mesure, qui vérifient la production des événements nécessaires à l’évaluation de ce comportement.
La qualité de collecte devient une composante de la Definition of Done.
Une fonctionnalité est considérée comme livrable lorsque son comportement fonctionnel et les exigences de mesure associées ont été validés.
Cette approche modifie également la responsabilité du tracking. La mesure devient une propriété du produit, partagée entre les équipes métier, analytics, développement et qualité.
2. Du plan de marquage au contrat de mesure
Le plan de marquage constitue traditionnellement un document de référence décrivant les événements à collecter, leurs paramètres et leurs conditions de déclenchement.
Sa transformation en contrat structuré permet de franchir une étape supplémentaire : rendre ces spécifications directement exploitables par des programmes.
Formaliser le contrat en YAML
YAML présente plusieurs caractéristiques intéressantes :
– Une syntaxe lisible par les équipes techniques.
– Une structure hiérarchique adaptée à la description des événements.
– Une intégration naturelle aux dépôts Git.
– Une exploitation possible par des validateurs, générateurs de documentation et outils de test.
Un contrat de mesure pourrait prendre la forme suivante :
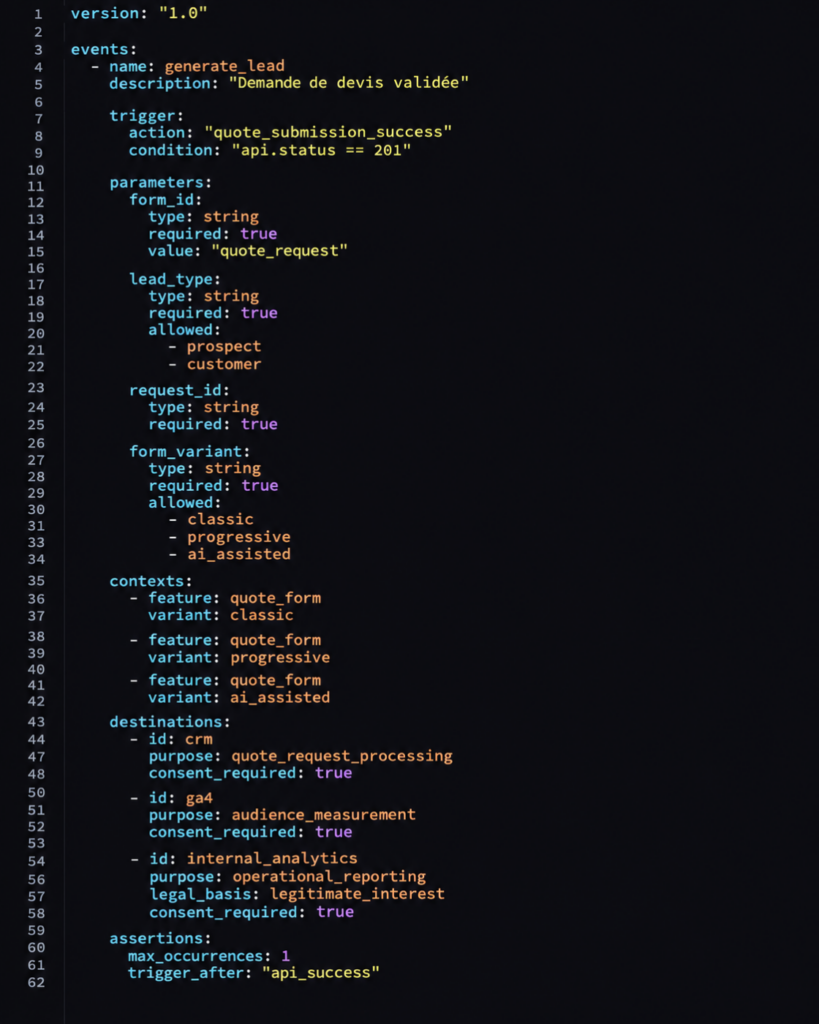
Exemple illustratif d’un contrat YAML. Les champs et conventions relèvent d’un modèle conceptuel à formaliser. La base légale indiquée pour la destination interne constitue une hypothèse à vérifier selon le traitement réel.
Ce fichier décrit l’événement, ses paramètres, ses conditions de déclenchement, les destinations de collecte et certaines règles de validation.
Il constitue un contrat de mesure entre le besoin métier et son implémentation technique.
Distinguer le format, le schéma et le moteur de validation
Cette approche repose sur trois éléments distincts.
Le YAML constitue le format de description. Il permet de représenter les exigences de mesure dans un fichier lisible et versionnable.
Le schéma définit la structure du contrat. Un JSON Schema, ou un mécanisme équivalent, peut vérifier la présence des propriétés obligatoires, les types de données, les valeurs autorisées et les conventions de nommage.
Le moteur de validation contrôle l’implémentation réelle. Il interprète les règles du contrat et confronte les événements attendus aux comportements observés dans l’application et son infrastructure de collecte.
La valeur du dispositif repose sur l’association d’un langage de description, de règles formelles et de mécanismes capables de vérifier leur application.
Une extension des pratiques d’ingénierie des données
Cette approche s’inscrit dans une évolution plus large de l’ingénierie logicielle et des données.
Les data contracts formalisent les engagements entre producteurs et consommateurs de données. Le contract testing consiste à vérifier qu’une implémentation respecte les exigences d’un contrat. L’observabilité permet de surveiller le comportement effectif d’un système en fonctionnement.
Le contrat de mesure transpose ces principes à la collecte digitale.
Le métier définit ce qu’il souhaite mesurer. Le contrat formalise les événements et les règles attendues. Les tests vérifient leur application avant livraison, tandis que la surveillance en production permet d’identifier les écarts qui apparaissent dans les conditions réelles d’utilisation.
L’intérêt réside dans la continuité entre la définition du besoin, son implémentation et son exploitation.
Introduire le versionning et la gouvernance
L’utilisation de Git permet de conserver l’historique des évolutions du contrat.
Chaque modification devient traçable : ajout d’un événement, évolution d’un paramètre, changement de destination ou modification d’une règle de collecte.
Les Pull Requests permettent d’organiser la revue de ces changements avant leur intégration.
Le plan de marquage quitte ainsi le statut de document annexe pour devenir un élément constitutif du patrimoine applicatif.
3. Maintenir le tracking dans un environnement applicatif mouvant
La maintenance du plan de marquage constitue l’une des principales difficultés du digital analytics, particulièrement dans les organisations qui pratiquent le déploiement continu.
Les applications évoluent à un rythme soutenu : nouvelles fonctionnalités, refontes de composants, expérimentations A/B, personnalisation des parcours et déploiements progressifs.
À cette complexité s’ajoute le feature flipping, qui permet d’activer ou de désactiver dynamiquement des fonctionnalités, indépendamment des mises en production.
Dans ce contexte, une même version applicative peut présenter plusieurs comportements selon le profil utilisateur, son environnement, son appartenance à un groupe expérimental ou la configuration des feature flags.
Plusieurs réalités fonctionnelles pour une même application
Prenons l’exemple d’un formulaire de demande de devis faisant l’objet d’une expérimentation :
– La version A propose un formulaire classique en une seule étape.
– La version B introduit un parcours progressif en trois étapes.
– La version C propose une saisie assistée par intelligence artificielle.
Ces trois parcours poursuivent le même objectif métier, mais produisent des interactions et des événements intermédiaires différents.
Le plan de marquage doit permettre de mesurer leur performance respective tout en conservant une lecture consolidée de la conversion.
Le véritable enjeu consiste à dissocier la stabilité des indicateurs métier de la variabilité des implémentations fonctionnelles.
Introduire la notion de contexte dans le contrat
Un contrat YAML peut intégrer les variantes applicatives concernées.
L’extrait suivant reprend une partie du contrat generate_lead présenté précédemment, en mettant l’accent sur les variantes fonctionnelles et les contextes applicatifs. Les autres paramètres et destinations restent définis dans le contrat de référence.
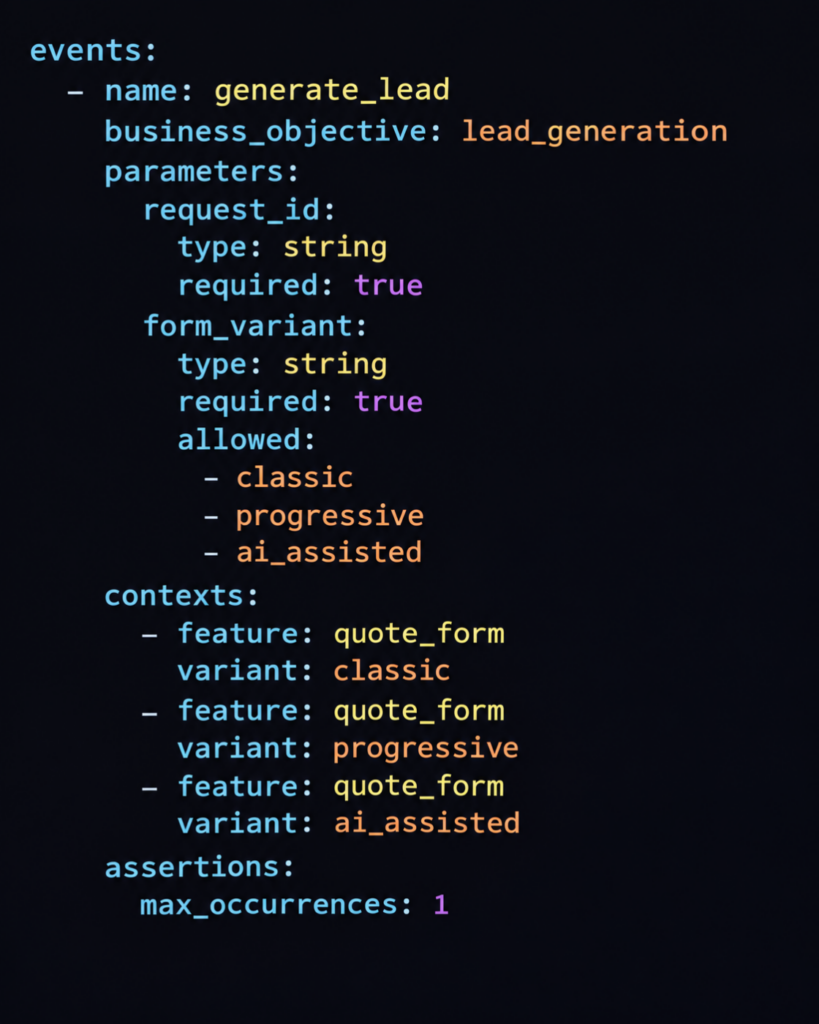
L’événement métier `generate_lead` conserve sa signification indépendamment du parcours utilisé.
Les paramètres de contexte permettent d’identifier la variante à l’origine de la conversion.
Les événements intermédiaires peuvent, quant à eux, être spécifiques à chaque implémentation.
Cette distinction préserve la continuité des indicateurs tout en accompagnant les évolutions du produit.
Synchroniser les feature flags et les tests
Un feature flag peut évoluer sans modification du code applicatif.
Son activation peut donc introduire un nouveau comportement dans une application déjà déployée.
Un pipeline CI/CD exécuté uniquement lors des modifications de code couvre imparfaitement cette situation.
L’approche proposée consiste à considérer la configuration des feature flags comme une dépendance explicite du contrat de mesure.
Le moteur de validation pourrait interroger une API de gestion des fonctionnalités afin d’identifier les variantes actives, les environnements concernés et les scénarios à tester.
Les tests seraient alors exécutés sur une sélection de configurations représentatives, définie selon les risques et les parcours critiques.
Une modification de configuration pourrait également déclencher une campagne de tests ciblée, indépendamment d’une nouvelle livraison applicative.
Maîtriser la dérive du plan de marquage
Dans un environnement mouvant, le risque principal est la divergence progressive entre trois réalités :
– Le tracking spécifié, correspondant aux événements définis dans le référentiel.
– Le tracking implémenté, correspondant aux événements effectivement produits par les différentes variantes applicatives.
– Le tracking exploité, correspondant aux données utilisées dans les rapports, tableaux de bord et modèles analytiques.
Ces trois niveaux peuvent évoluer à des rythmes différents.
Une fonctionnalité supprimée peut laisser subsister des événements dans le plan de marquage. Un nouveau parcours peut introduire des paramètres supplémentaires. Un tableau de bord peut continuer à exploiter un événement dont la signification métier a évolué.
La gestion de cette dérive suppose de documenter les dépendances entre fonctionnalités, événements et indicateurs.
Le référentiel pourrait intégrer le cycle de vie de chaque événement : actif, déprécié ou retiré, avec les versions et configurations applicatives concernées.
L’analyse automatisée des changements permettrait d’identifier les contrats potentiellement affectés et de proposer les adaptations nécessaires.
Le plan de marquage devient ainsi un référentiel vivant, capable de représenter plusieurs états fonctionnels d’un même produit.
4. Exploiter le référentiel par API
La formalisation du plan de marquage ouvre la possibilité de construire un référentiel centralisé, exploitable par plusieurs outils.
Une API peut exposer les contrats de mesure et fournir les informations nécessaires aux différentes étapes du cycle de développement.
Par exemple :
– `GET /api/tracking/events`
– `GET /api/tracking/events/generate_lead`
– `GET /api/tracking/contracts/1.0`
– `GET /api/tracking/coverage`
Ces endpoints constituent des exemples d’interfaces envisageables.
L’intérêt réside dans la mutualisation du référentiel.
Le même contrat peut alimenter une documentation destinée aux équipes métier, un validateur utilisé par les développeurs, un générateur de tests et un outil de contrôle des configurations déployées.
Préparer les données et les états de test
L’API peut également exposer les scénarios de validation et les jeux de données associés.
Pour une demande de devis, elle pourrait fournir les caractéristiques d’un prospect fictif, les états applicatifs nécessaires à l’exécution du parcours et les événements attendus.
La préparation des données et des états de test nécessite des mécanismes dédiés : jeux de données de test, simulation des réponses API, préparation des environnements ou réinitialisation des données.
Comparer l’attendu au déployé
Un autre usage consiste à confronter le contrat de mesure aux configurations réellement utilisées par l’application.
Des composants logiciels peuvent récupérer les configurations accessibles des outils de collecte, notamment les conteneurs GTM, puis identifier certains écarts.
Cette comparaison peut porter sur les noms d’événements, les paramètres, les déclencheurs et les destinations.
Elle reste complémentaire aux tests d’exécution : une configuration conforme au contrat ne garantit pas, à elle seule, que l’application produira les événements attendus.
5. Intégrer le consentement au contrat de mesure
La conformité réglementaire représente une dimension essentielle de la qualité de collecte.
Un même événement métier peut alimenter plusieurs traitements poursuivant des finalités distinctes.
La transmission d’une demande de devis au système commercial, sa mesure statistique dans un outil analytics et son exploitation à des fins publicitaires répondent à des logiques différentes.
Ces traitements peuvent relever de bases légales, de règles de consentement et d’exigences techniques différentes.
Le contrat de mesure doit donc distinguer :
- La finalité poursuivie par chaque traitement.
- La base légale applicable.
- La destination des données.
- Les préférences ou consentements nécessaires.
- Le comportement attendu selon l’état du consentement.
- Les règles de minimisation des données transmises.
Décrire les comportements attendus
Un événement ‘generate_lead’ peut correspondre à une conversion commerciale réelle, indépendamment de son éventuelle transmission à un service tiers de mesure.
Le contrat doit donc distinguer l’existence de l’événement métier de son autorisation de transmission à chaque destination.
Pour une destination soumise au consentement, plusieurs scénarios peuvent être définis : consentement accordé, refusé, retiré ou partiellement accordé lorsque le dispositif prévoit une gestion granulaire des finalités.
Ces scénarios peuvent devenir des critères d’acceptation automatisés.
Une vérification pourrait ainsi confirmer que la conversion commerciale est correctement enregistrée par l’application tout en contrôlant que les transmissions analytics respectent les préférences exprimées.
La gestion des réglementations territoriales introduit une dimension supplémentaire. Les règles applicables peuvent dépendre du territoire, de la finalité, de la destination et des caractéristiques du traitement.
Le contrat doit permettre d’exprimer ces conditions sans confondre la réglementation applicable, la base légale et l’état technique du consentement.
Vérifier les règles dans les tests
Les tests automatisés peuvent reproduire différents états de consentement et observer les requêtes effectivement émises.
Le contrôle porte alors sur la présence ou l’absence des transmissions attendues, les paramètres envoyés et les éventuelles transformations appliquées.
La validation doit également tenir compte du retrait du consentement en cours de session.
Cette approche transforme une partie des exigences de conformité en comportements techniques vérifiables.
Elle complète l’analyse juridique et la gouvernance des traitements, qui demeurent nécessaires pour déterminer les règles à appliquer.
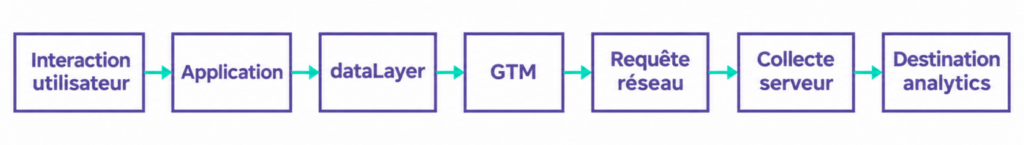
6. Tester toute la chaîne de collecte
La validation du tracking se concentre encore fréquemment sur la présence d’un événement dans le dataLayer ou sur l’observation d’une requête réseau.
Ces contrôles couvrent seulement une partie du dispositif.
Un événement peut être correctement émis par l’application, puis transformé de manière incorrecte, filtré par une configuration ou rejeté par sa destination.
Une stratégie de test complète doit considérer plusieurs niveaux :
Automatiser les parcours avec Playwright
Playwright permet de reproduire des interactions utilisateur dans un navigateur automatisé.
Il peut ouvrir une page, remplir un formulaire, déclencher une action et vérifier les comportements observables.
Les tests peuvent ensuite contrôler les événements du dataLayer et intercepter les requêtes envoyées aux services de collecte.
Exemple simplifié :
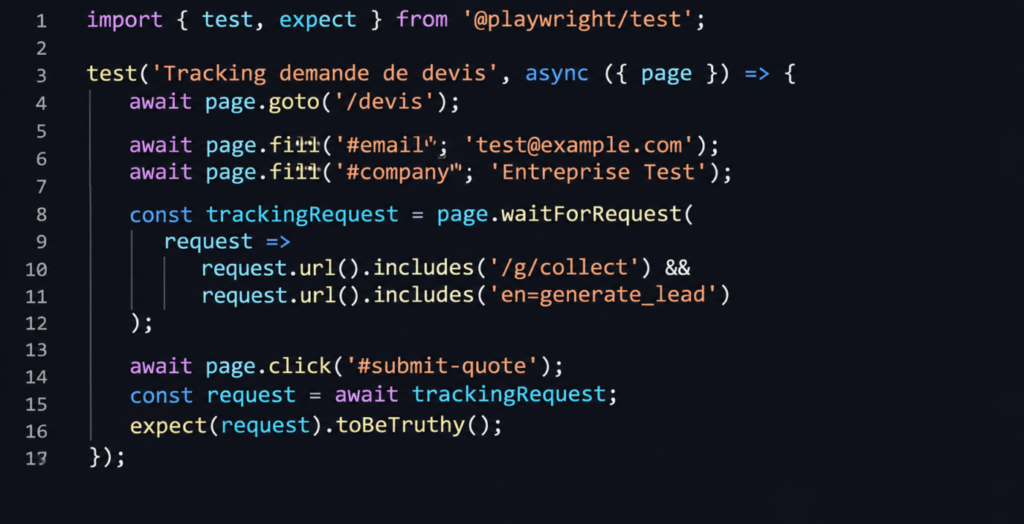
Ce premier contrôle vérifie l’émission d’une requête correspondant à l’événement attendu. Il suppose un environnement de test autorisant cette collecte et un parcours de formulaire fonctionnel.
Une implémentation industrielle doit aller plus loin.
Elle doit notamment vérifier :
- La présence et le type des paramètres obligatoires.
- La cohérence des valeurs transmises.
- Le nombre d’occurrences de chaque événement.
- L’ordre des événements dans un parcours.
- Les conditions de déclenchement.
- Le comportement selon les états de consentement.
- Les transformations appliquées par le serveur de collecte.
Distinguer les niveaux de preuve
La fiabilité d’un événement ne peut être établie à partir d’un seul point de contrôle.
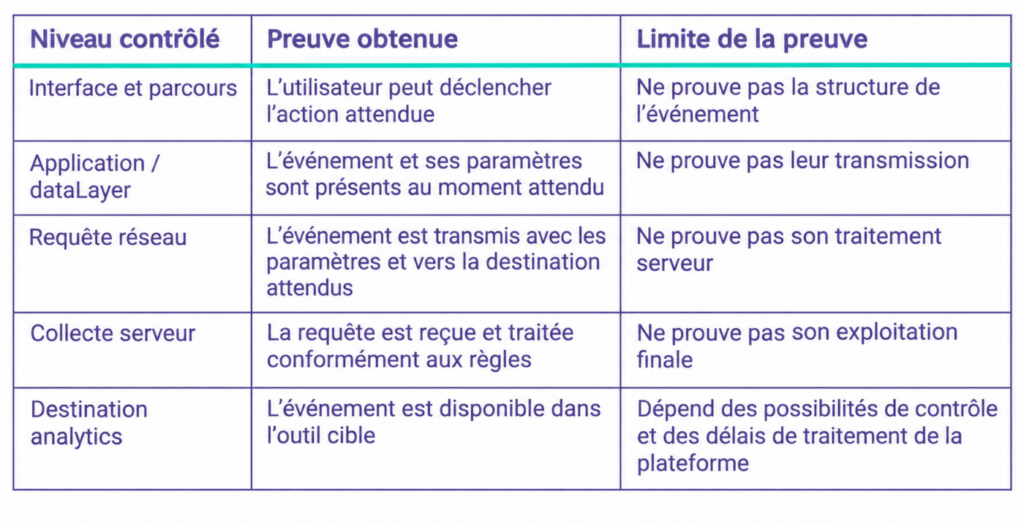
Chaque niveau apporte une preuve partielle.
L’objectif consiste à combiner ces contrôles pour identifier les principales ruptures de collecte avant livraison, puis à compléter cette validation par une surveillance en production.
Tester également la réception serveur
Le contrôle du navigateur apporte une preuve d’émission, mais la réception effective nécessite un point d’observation supplémentaire.
Dans une architecture server-side, un collecteur de test peut enregistrer les requêtes reçues, les transformations effectuées et les événements transmis aux destinations simulées.
Cette instrumentation permet de comparer trois états :
- L’événement attendu par le contrat.
- L’événement émis par l’application.
- L’événement effectivement reçu et traité par l’infrastructure de collecte.
Les tests doivent également couvrir les parcours d’échec : formulaire invalide, erreur API, abandon, nouvelle tentative et changement de consentement.
La vérification de la réception par un collecteur simulé apporte une preuve de conformité dans l’environnement de test.
La réception et l’exploitation effectives par une plateforme tierce nécessitent des contrôles complémentaires, lorsque cette plateforme offre des mécanismes d’observation adaptés.
L’objectif est de valider la cohérence de toute la chaîne, plutôt que la seule présence d’un tag.
7. Mobiliser l’agentique pour les tests de non-régression
L’intelligence artificielle apporte une dimension supplémentaire à cette organisation.
Les agents de développement peuvent exploiter les contrats YAML, les modifications de code et les résultats des tests pour assister les équipes dans la maintenance du dispositif de mesure.
Leur intérêt se situe particulièrement dans les tests de non-régression.
Identifier les impacts d’une modification
Lorsqu’une Pull Request modifie un formulaire, un composant de navigation ou une API, un agent peut analyser les fichiers concernés et les rapprocher des événements définis dans le référentiel.
Il peut alors proposer les parcours de tracking susceptibles d’être affectés.
Les entrées de cette analyse sont identifiables : contrat de mesure, modifications de code, dépendances applicatives et catalogue des tests existants.
Le résultat attendu est une liste de scénarios à exécuter, accompagnée des événements concernés et des raisons de leur sélection.
Cette analyse constitue une aide à la couverture des tests, plutôt qu’une garantie d’exhaustivité.
Proposer et générer des scénarios
À partir du contrat `generate_lead`, un agent pourrait proposer plusieurs scénarios :
- Soumission réussie avec consentement analytics accordé.
- Soumission réussie avec consentement analytics refusé.
- Échec de validation du formulaire.
- Erreur de traitement serveur.
- Double clic sur le bouton de validation.
Les contrôles attendus sont dérivés du contrat, tandis que les interactions techniques sont adaptées à l’application.
Les tests générés doivent être exécutés et validés avant d’être intégrés au dispositif de qualité.
Analyser les échecs
Lorsqu’un test échoue, l’agent peut rapprocher les journaux d’exécution, les requêtes réseau, les modifications de code et les règles du contrat.
Il peut formuler des hypothèses : événement renommé, paramètre manquant, déclenchement prématuré, modification d’un sélecteur ou changement dans la gestion du consentement.
Il peut ensuite proposer un correctif ou une adaptation du test.
Définir les responsabilités de l’agent
L’agent intervient dans la préparation, l’exécution assistée et l’analyse des contrôles.
Il peut identifier les parcours potentiellement affectés, proposer des scénarios, générer des tests et contribuer à l’investigation des anomalies.
La validation des exigences métier, l’approbation des modifications du contrat et les décisions de livraison restent sous responsabilité humaine.
Cette séparation est essentielle : un agent capable de modifier automatiquement un test après son échec pourrait finir par accepter un comportement devenu incorrect.
L’agentique accélère la production et la maintenance des contrôles. Le contrat de mesure et les règles de validation restent les références.
8. Automatiser Google Tag Manager : vers le GTM-as-Code
L’intégration du tracking à la chaîne de production logicielle appelle une étape supplémentaire : automatiser la configuration et le déploiement des conteneurs Google Tag Manager (GTM) à partir du contrat de mesure.
Le contrat YAML décrit les événements attendus. Les tests automatisés vérifient leur émission et leur traitement.
L’API Google Tag Manager v2 permet de piloter les composants de collecte : variables, déclencheurs, balises, espaces de travail et versions.
Cette capacité ouvre la possibilité d’intégrer la configuration de GTM aux mêmes processus de versionnement, de validation et de livraison que le code applicatif.
Du GTM manuel au GTM-as-Code
Dans une organisation traditionnelle, le développement d’une fonctionnalité est suivi d’une intervention dans l’interface GTM pour créer ou modifier les variables, déclencheurs et balises nécessaires à sa mesure.
Ces opérations constituent une chaîne de configuration parallèle à celle du développement logiciel.
Le principe du GTM-as-Code consiste à générer et synchroniser les composants GTM à partir d’un référentiel déclaratif.
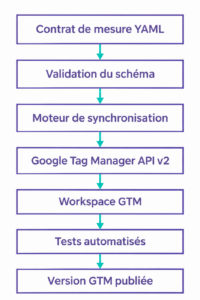
Le contrat YAML devient la référence des exigences de mesure.
Un mécanisme de synchronisation assure leur traduction dans le modèle de configuration propre à GTM.
Cette traduction suppose des composants capables de convertir les événements, paramètres, conditions et destinations en ressources compatibles avec l’API.
Provisionner les composants par API
L’API Google Tag Manager v2 expose notamment des opérations de création et de modification des espaces de travail, variables, déclencheurs et balises.
Pour un événement `generate_lead`, le système pourrait réaliser les opérations suivantes :
- Créer les variables : Chaque paramètre attendu dans le dataLayer peut être associé à une variable GTM, notamment
form_id,lead_type,request_idetform_variant. - Créer les déclencheurs : un déclencheur de type Custom Event peut écouter l’événement `generate_lead` émis par l’application.
- Créer les balises : une balise GA4 peut être configurée pour transmettre l’événement et ses paramètres vers la destination prévue. D’autres composants peuvent prendre en charge les destinations publicitaires ou les infrastructures de collecte server-side.
- Synchroniser les ressources : le système compare les ressources déclarées dans le contrat aux ressources existantes dans GTM. Il détermine les créations, modifications et suppressions nécessaires, tout en préservant les éléments du conteneur situés hors de son périmètre de gestion.
Cette approche permet de limiter les appels API et de réduire les risques de modifications involontaires.
Exemple : créer un déclencheur GTM
Pour l’événement `generate_lead`, une requête de création pourrait utiliser l’endpoint suivant :
http

POST https://tagmanager.googleapis.com/tagmanager/v2/accounts/{account_id}/containers/{container_id}/workspaces/{workspace_id}/triggers
Avec une représentation JSON du déclencheur :
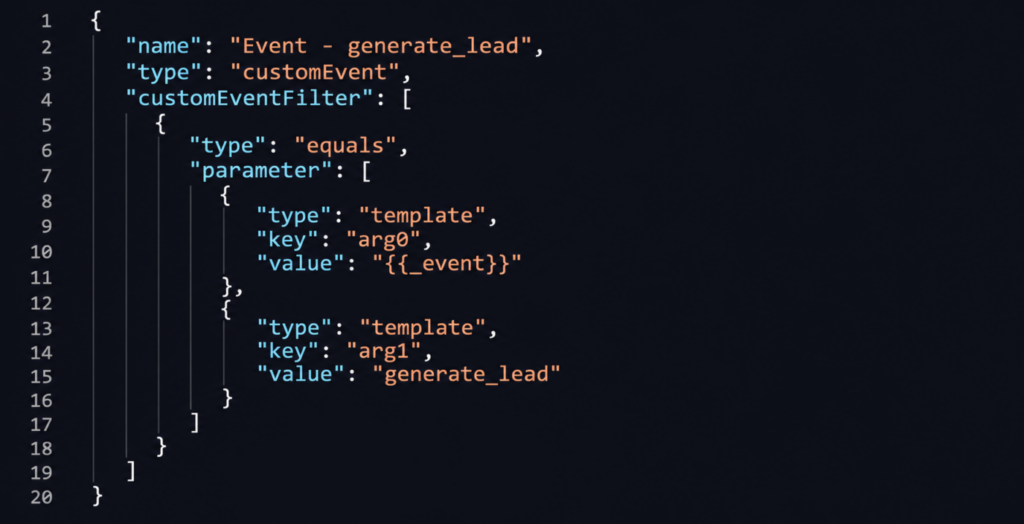
Cet exemple illustre la correspondance entre un événement défini dans le contrat et un déclencheur GTM.
La création de la balise associée nécessite ensuite la configuration de son type, de ses paramètres, de ses références aux variables et de l’identifiant du déclencheur.
Les structures exactes dépendent du type de balise et des modèles pris en charge par l’API. Elles doivent être validées sur la configuration GTM cible.
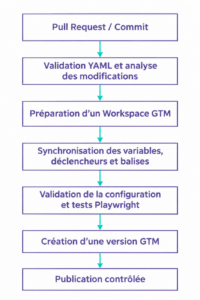
Intégrer le déploiement GTM au pipeline
Le provisionnement peut être intégré à une chaîne de livraison automatisée.
Gérer le cycle de vie des Workspaces
L’automatisation implique de gérer les espaces de travail GTM comme des ressources partagées entre plusieurs opérations de développement.
Une organisation possible consiste à suivre les étapes suivantes :
- Réserver un espace de travail : identifier un Workspace disponible ou en créer un dans la limite des ressources autorisées.
- Identifier les modifications : associer l’espace de travail à une demande d’évolution et à une version du contrat.
- Synchroniser la configuration : appliquer uniquement les différences entre le contrat et les ressources GTM administrées.
- Valider : contrôler la configuration produite et exécuter les tests avec une version de test adaptée.
- Créer une version : transformer les modifications validées en version GTM.
- Publier : déclencher la publication selon les règles de validation définies.
- Gérer les échecs : nettoyer les espaces de travail devenus inutiles et conserver la traçabilité des opérations.
Un point technique mérite une attention particulière : **la création d’une version depuis un Workspace entraîne la suppression de ce Workspace source**.
Le système doit donc suivre les espaces disponibles, ceux utilisés par des opérations en cours et ceux dont les modifications ont été converties en versions.
Cette gestion devient importante lorsque plusieurs équipes modifient simultanément un même conteneur.
Valider la configuration avant publication
Le pipeline peut contrôler la structure des ressources GTM, leur correspondance avec le contrat et les éventuels conflits de configuration.
Les tests Playwright doivent ensuite être exécutés avec une configuration GTM de test correspondant aux modifications préparées.
L’utilisation du mode Preview nécessite un mécanisme adapté pour établir la session de prévisualisation et la rendre accessible au navigateur automatisé.
Publier et versionner
Après validation, l’API permet de créer une version à partir du Workspace, puis de publier cette version.
La version GTM peut être associée à l’identifiant du commit applicatif, au numéro de livraison et à la version du contrat YAML.
Cette association établit une traçabilité entre trois éléments :
- La version du code applicatif.
- La version du contrat de mesure.
- La version de configuration GTM.
La publication du code et celle de GTM restent deux opérations distinctes.
Leur coordination doit donc prévoir l’ordre des déploiements, les vérifications de compatibilité et les procédures de retour arrière.
Gérer le client-side et le server-side
Dans une architecture server-side, la configuration peut concerner plusieurs conteneurs GTM.
Le conteneur web produit ou relaie les événements vers l’infrastructure de collecte. Le conteneur serveur reçoit les requêtes, applique ses règles de traitement et transmet les données aux destinations.
Le système doit donc gérer les dépendances entre ces deux environnements.
Une stratégie possible consiste à préparer et valider les composants server-side avant d’activer les configurations web qui en dépendent.
Les défis techniques du GTM-as-Code
L’automatisation du déploiement introduit plusieurs contraintes.
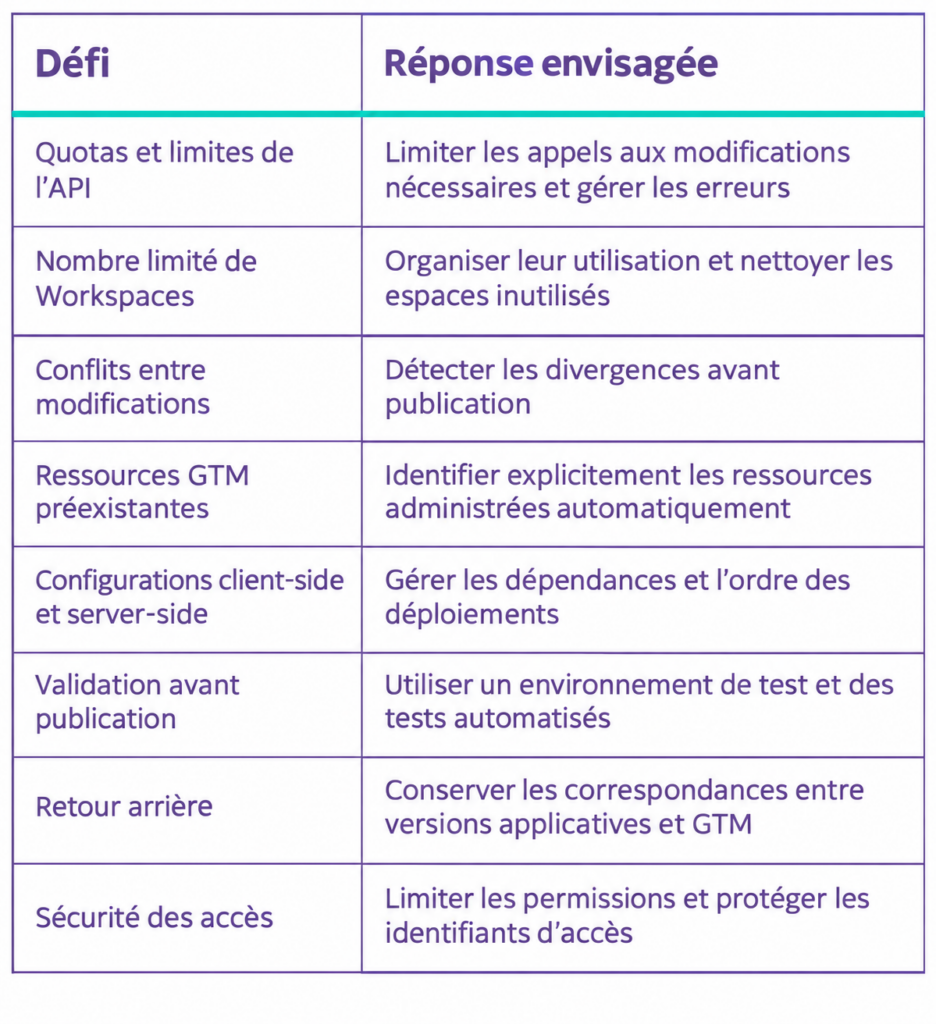
La gestion des ressources existantes mérite une attention particulière.
Le système doit reconnaître les composants qu’il administre, préserver les configurations indépendantes et détecter les modifications réalisées directement dans GTM.
Il doit également distinguer une modification volontaire du contrat d’une intervention manuelle effectuée en dehors du processus.
Cette comparaison régulière entre le référentiel Git et la configuration GTM constitue un mécanisme essentiel de maintien de la cohérence.
Fermer la boucle du Tracking-as-Code
L’automatisation de GTM complète la chaîne de production du tracking.
Le métier définit les objectifs et les exigences de mesure. Le contrat YAML formalise les événements, les paramètres, les destinations et les règles applicables.
Le développement implémente les interactions et les événements dans l’application. Le système de synchronisation prépare les configurations GTM.
Les tests automatisés vérifient les comportements de collecte. La CI/CD coordonne la validation et la publication des différentes versions.
Le tracking devient alors une chaîne déclarative, versionnée, testable et potentiellement déployable automatiquement.
L’intervention humaine se déplace de la configuration répétitive des conteneurs vers la définition des exigences, la gouvernance des contrats et la validation des évolutions.
9. Intégrer les contrôles à la CI/CD
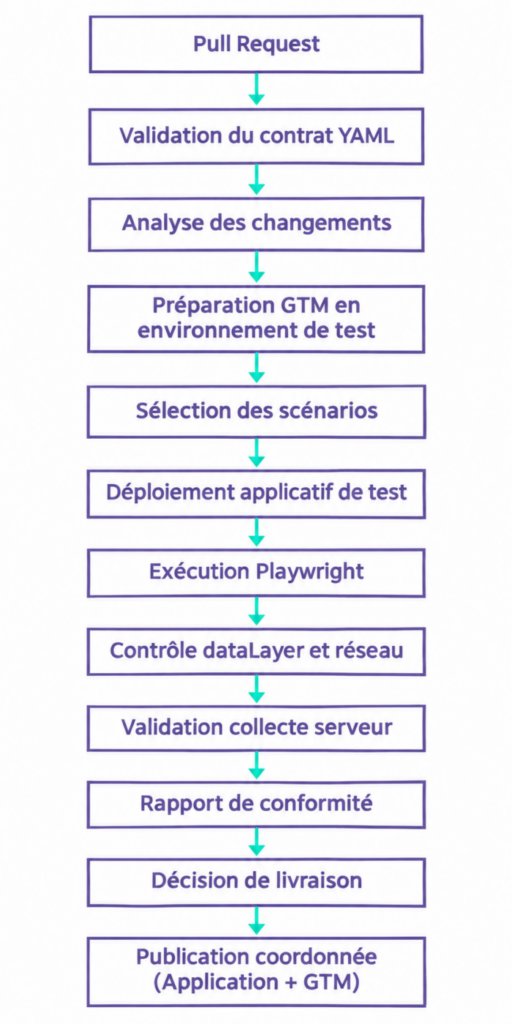
L’intégration continue constitue le point de convergence de cette approche.
Chaque Pull Request peut déclencher une série de validations destinées à vérifier la conformité de l’application au contrat de mesure.
Le pipeline doit couvrir à la fois le code applicatif et les configurations des outils de collecte.
Définir des règles bloquantes
Tous les écarts de collecte ne présentent pas le même niveau de criticité.
Une organisation peut définir des règles de validation différenciées.
L’absence d’un événement de conversion critique, la transmission d’une donnée interdite ou l’émission d’un événement soumis au consentement malgré son refus peuvent entraîner le blocage du pipeline.
Une anomalie sur un événement secondaire peut faire l’objet d’un avertissement et d’une correction planifiée.
Ces seuils doivent être explicitement définis dans la gouvernance du projet.
Une collecte conforme ? Encore faut-il pouvoir le démontrer.
Chaque exécution peut produire un rapport associant les scénarios testés, les règles de validation, les événements observés et les résultats.
Les traces Playwright, les journaux de collecte et les écarts au contrat constituent des éléments de preuve exploitables lors des revues.
Le rapport peut être associé à l’identifiant du commit, à la version du contrat YAML, à celle de la configuration GTM et aux états des feature flags testés.
Cette traçabilité permet de retrouver précisément les conditions dans lesquelles une version applicative a été validée.
La qualité du tracking devient une propriété vérifiable de chaque livraison.
10. Cas pratique : une demande de devis
Pour illustrer concrètement cette approche, imaginons un scénario dans lequel une équipe produit souhaite simplifier un formulaire de demande de devis et mesurer son effet sur la génération de leads.
Cet exemple fictif permet de parcourir les différentes étapes, de la formalisation du contrat de mesure jusqu’à la détection d’une régression avant mise en production.
- Étape 1 : Définir le besoin
L’objectif métier est d’améliorer le taux de conversion des demandes de devis.
Deux événements sont retenus : `quote_form_start`, correspondant à la première interaction, et `generate_lead`, déclenché après confirmation.
Le contrat précise que `generate_lead` doit être émis une seule fois par demande acceptée. - Étape 2 : Formaliser le contrat
Le plan YAML définit les paramètres obligatoires, les conditions de déclenchement et les règles de transmission selon les destinations.
Le paramètre `request_id` permet d’identifier chaque demande et de contrôler les doublons. - Étape 3 : Préparer GTM
Le système de synchronisation prépare les variables, déclencheurs et balises dans un espace de travail GTM dédié, puis soumet cette configuration aux contrôles prévus. - Étape 4 : Générer et exécuter les tests
Un agent analyse le contrat et propose les scénarios Playwright : demande valide, erreur, double soumission et différents états de consentement.
Un collecteur de test enregistre les événements reçus. - Étape 5 : Détecter une régression
À la suite d’une modification du formulaire, un test pourrait détecter deux émissions de generate_lead pour une seule demande : une au clic et une à la confirmation API. - Étape 6 : Corriger avant livraison
Le déclenchement est repositionné sur la confirmation de succès et une protection contre les doublons est ajoutée.
Les tests relancés valident l’émission unique.
La version applicative et la configuration GTM peuvent alors être publiées.
11. Organiser la responsabilité et la couverture
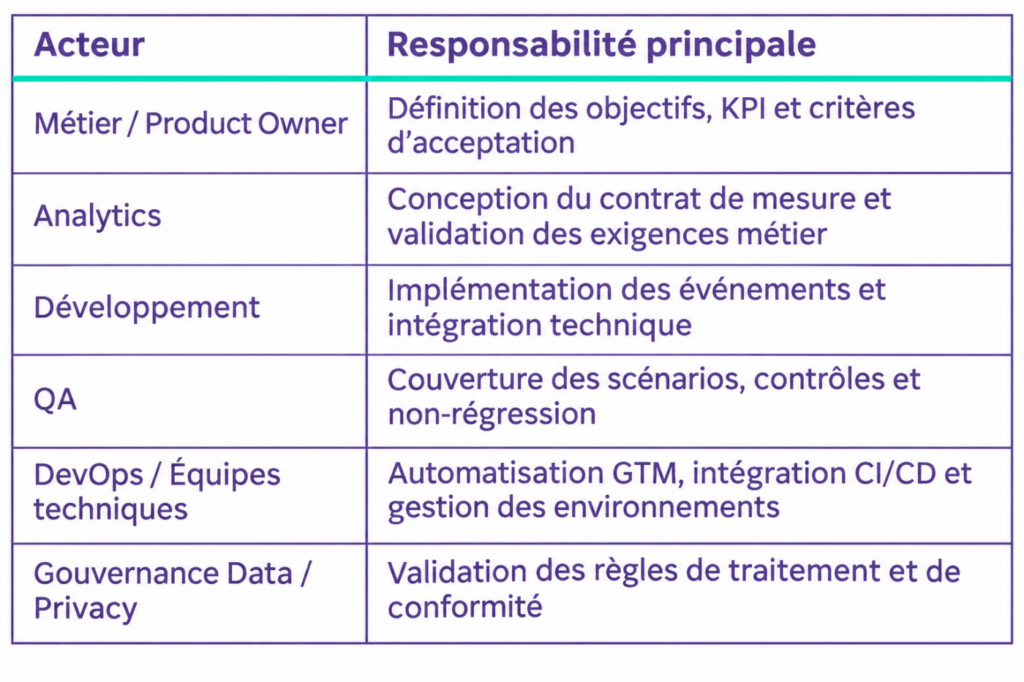
L’automatisation du tracking suppose une organisation claire des responsabilités.
Mesurer la couverture du tracking
Le nombre d’événements définis dans un plan de marquage constitue un indicateur insuffisant de sa qualité.
Une approche plus pertinente consiste à mesurer la couverture des parcours métier critiques :
- Le pourcentage de parcours critiques disposant d’un contrat de mesure.
- Le pourcentage d’événements critiques couverts par des tests automatisés.
- Le taux de conformité des contrôles exécutés.
- Le nombre de régressions détectées avant livraison.
- Le nombre d’anomalies de collecte découvertes en production.
- Le taux de conformité entre contrats versionnés et configurations GTM déployées.
Compléter les tests par la surveillance en production
Les tests exécutés avant livraison valident des scénarios connus dans un environnement maîtrisé.
La production introduit d’autres variables : navigateurs, extensions, bloqueurs, réseaux, consentements et variations de trafic.
Une surveillance continue reste donc nécessaire : volumes d’événements, ratios de conversion, paramètres manquants et erreurs de collecte.
Les tests CI/CD et la surveillance en production sont complémentaires.
Cette répartition des responsabilités soulève une question plus fondamentale : si la conception et la validation de la mesure restent indispensables, nécessitent-elles encore une fonction spécialisée ? Les compétences analytics conserveraient toute leur valeur, mais leur intégration progressive aux équipes produit, développement et qualité pourrait transformer profondément le métier de Digital Analyst.
Reste alors à déterminer qui portera durablement cette expertise transverse.
12. Vers la fin du métier de Digital Analyst ?
Une grande partie de ses activités historiques repose sur la traduction des besoins métier en plans de marquage, la rédaction de spécifications, la validation des implémentations, le contrôle de la qualité des données et la production de rapports.
Or, chacune de ces activités entre progressivement dans le périmètre de l’automatisation.
Les contrats YAML structurent les spécifications. Les API automatisent la configuration. Les pipelines CI/CD assurent les contrôles. Les agents IA génèrent les tests et analysent les échecs.
Les interfaces conversationnelles simplifient également l’exploration des données pour le métier.
Une disparition par absorption plutôt que par suppression
L’hypothèse est celle d’une disparition progressive du métier par intégration de ses compétences dans d’autres fonctions :
– Le tracking devient une responsabilité native du développement logiciel.
– La qualité de collecte rejoint les processus QA.
– La gouvernance technique s’intègre au Data Engineering.
– L’automatisation GTM transfère la création de balises vers les opérations de déploiement automatisé.
Le Digital Analyst pourrait disparaître comme fonction spécialisée précisément parce que la mesure serait devenue une capacité native, collective et industrialisée.
Le Business Analyst conserve sa raison d’être
Cette perspective doit être distinguée de l’avenir de l’analyse métier.
L’automatisation permet de produire et contrôler la donnée, mais la disponibilité d’une information ne constitue pas une capacité de décision.
Le Business Analyst conserve une fonction essentielle : transformer les données en compréhension métier, puis en décisions.
Cette responsabilité exige une connaissance approfondie de l’organisation, la capacité de remettre en question les indicateurs et de distinguer corrélation et causalité.
La fin du Digital Analyst technique pourrait ainsi accompagner le renforcement du Business Analyst stratégique.
13. Passons ce modèle à l’épreuve des balles
Dans cette démarche exploratoire, j’ai créé QOSA (Quick Original Software Adventures), une plateforme d’expérimentation dédiée à la conception et au développement d’applications web.
L’objectif est d’explorer concrètement les possibilités offertes par l’intelligence artificielle dans le développement logiciel, de confronter les idées à leur réalisation technique et de mesurer la capacité de ces nouvelles approches à produire des solutions fonctionnelles, performantes et durables.
Le projet Tracking & CI
Cette réflexion s’inscrit dans le cadre de QOSA (Quick Open Software Adventures), une plateforme exploratoire que j’ai développée pour expérimenter de nouvelles approches, concevoir des applications web et confronter des idées à leur faisabilité technique.
QOSA Tracking & CI constitue l’une de ces expérimentations. Ce projet, actuellement en cours de développement, vise à éprouver la possibilité d’intégrer les exigences de mesure au cycle de production logicielle.
L’ambition consiste à éprouver la faisabilité d’une chaîne de mesure intégrée au cycle de production logicielle.
Il s’agit à ce stade d’une démarche exploratoire. Les mécanismes présentés constituent des hypothèses techniques à confronter à des tests, à des contraintes opérationnelles et à des résultats mesurables.
Trois questions structurent particulièrement cette exploration :
- Automatiser Google Tag Manager par API : dans quelle mesure est-il possible de préparer les configurations GTM à partir d’un contrat YAML, de gérer les espaces de travail et de limiter les modifications aux ressources réellement concernées ?
- Fiabiliser les tests Playwright : comment maintenir des contrôles de tracking stables malgré les évolutions graphiques, les changements de parcours et les variations des environnements de test ?
- Rendre le contrat YAML accessible : comment permettre aux équipes métier d’exprimer directement leurs besoins, sans leur imposer la maîtrise du YAML ou de Git ?
Sur ce dernier point, deux approches pourraient être envisagées.
La première repose sur une interface de génération de contrats YAML, conçue autour des capacités et du vocabulaire des équipes métier. Elle s’appuierait sur une standardisation des besoins de mesure et un ensemble de questions fermées permettant de qualifier progressivement les objectifs, les événements, leurs conditions de déclenchement et les données attendues.
Cette approche permettrait de structurer les demandes, de mutualiser les cas d’usage récurrents et de produire des contrats cohérents à partir d’un référentiel commun (une sorte de design system).
La seconde piste fait appel à l’intelligence artificielle. J’entends déjà certaines voix proposer de s’affranchir de cette interface au profit d’une simple expression du besoin en langage naturel.
Une équipe produit pourrait alors décrire ses attentes à un agent chargé de les traduire en contrat YAML, de relever les éventuelles ambiguïtés et de soumettre le résultat à la validation métier.
Ces deux approches poursuivent le même objectif, avec une différence fondamentale : la première structure le besoin avant sa traduction technique ; la seconde confie à l’IA une partie de ce travail de structuration et d’interprétation.
Dans les deux cas, le contrat généré reste soumis à des contrôles de cohérence et à une validation métier.
Le YAML conserverait son rôle de référence technique, tandis que l’expression du besoin resterait accessible aux profils non techniques.
Cette médiation permettrait de **déplacer la friction syntaxique vers la relecture et la validation du contrat généré. L’effort humain porterait davantage sur l’exactitude des exigences que sur leur transcription dans un format technique.
Une trajectoire expérimentale en trois paliers
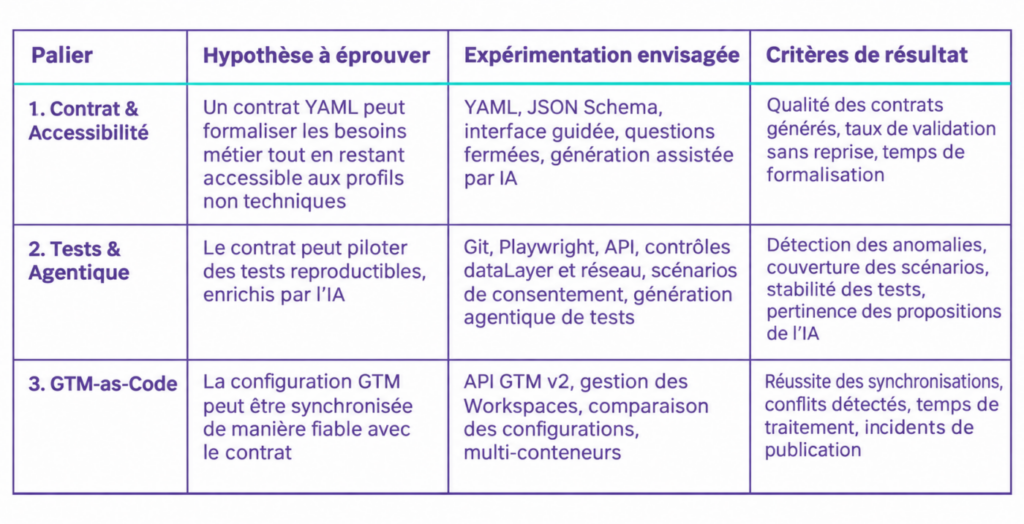
Ces critères permettront de distinguer la faisabilité technique, la stabilité des mécanismes et leur intérêt opérationnel.
Les résultats devront également permettre d’identifier les situations dans lesquelles une automatisation partielle présente un meilleur rapport entre complexité et bénéfices.
14. Les limites du modèle : regarder la réalité du terrain en face
Toute tentative d’industrialisation logicielle se heurte à des frictions humaines, techniques et organisationnelles.
L’approche Tracking-as-Code ne fait pas exception.
Si l’architecture envisagée est cohérente, sa mise en œuvre opérationnelle soulève plusieurs difficultés qu’il convient d’examiner.
Le piège de la charge mentale et du rejet du YAML par le Produit
Le premier risque est d’ordre humain.
Le format YAML constitue une source de référence intéressante pour les développeurs, mais il reste peu accessible à la majorité des Product Owners, responsables marketing ou Business Analysts.
Exiger d’un profil métier qu’il rédige des fichiers YAML et effectue des Pull Requests sur Git crée une barrière à l’adoption.
Le risque immédiat est de voir les équipes continuer à formaliser leurs besoins dans des tableurs, chargeant ensuite les développeurs de leur traduction technique.
Les deux pistes évoquées précédemment, interface guidée et génération assistée par IA, visent à rendre le contrat de mesure accessible aux équipes métier. Leur pertinence dépendra notamment de leur capacité à restituer fidèlement les exigences exprimées et à faciliter leur validation, sans introduire de complexité supplémentaire dans les processus de travail.
L’illusion du « tout-automatique » sur Google Tag Manager
La configuration de GTM par API v2 offre une perspective intéressante, mais l’écosystème impose des contraintes.
Le nombre de Workspaces GTM simultanément disponibles dépend notamment des limites applicables au conteneur et de la version souscrite (3 en version gratuite).
Dans une organisation où plusieurs équipes ouvrent des Pull Requests en parallèle, la gestion des espaces de travail peut devenir un point de blocage.
La configuration des balises et déclencheurs par API présente également une complexité supérieure à celle d’un simple fichier YAML.
La maintenance d’un système capable de comparer les configurations, de détecter les conflits et de gérer les publications représente un investissement technique réel.
Pour certaines organisations, un premier niveau consistant à valider le dataLayer en CI/CD tout en conservant une configuration GTM semi-automatisée pourrait présenter un meilleur rapport entre coût et bénéfice.
L’automatisation complète constitue donc une possibilité à évaluer selon les volumes, la fréquence des évolutions et les moyens disponibles.
La fragilité des tests E2E et le risque du « Bypass CI »
Le troisième écueil concerne la stabilité des tests Playwright.
Les applications web évoluent à un rythme soutenu : refontes graphiques, ajustements UX et modifications des composants d’interface.
L’utilisation d’attributs dédiés comme `data-testid` permet de rendre les tests moins sensibles aux changements de présentation.
Elle ne résout toutefois qu’une partie du problème.
Les tests peuvent également échouer en raison de délais de réponse variables, de problèmes de synchronisation, de données de test incohérentes ou d’erreurs réseau intermittentes.
La fiabilité du dispositif suppose donc une approche plus large : préparer des états applicatifs reproductibles, simuler certaines réponses API, utiliser des attentes adaptées aux traitements asynchrones et distinguer les anomalies réelles des incidents d’exécution.
Un système qui bloque régulièrement les livraisons pour des raisons indépendantes du tracking risque de perdre la confiance des équipes.
La tentation de contourner les contrôles devient alors un risque organisationnel autant que technique.
Une culture à construire plutôt qu’un outil à installer
Enfin, la perspective d’une absorption du rôle technique du Digital Analyst par les développeurs et les équipes QA se heurte à une réalité de compétences.
Les développeurs maîtrisent la production logicielle, mais la modélisation analytics, les mécanismes d’attribution, les spécificités des plateformes de mesure ou l’évolution des règles de consentement relèvent d’une expertise particulière.
Cette redistribution laisse une question essentielle ouverte :
Qui portera durablement l’expertise analytics transverse ?
Entre l’ingénierie logicielle et la vision stratégique du Business Analyst, la gouvernance globale de la donnée, la cohérence des modèles d’attribution et l’interprétation des règles de confidentialité restent des responsabilités à organiser.
La disparition éventuelle d’une fonction spécialisée ne signifie donc pas la disparition de ses compétences.
Elle pose au contraire la question de leur répartition, de leur transmission et de leur maintien dans la durée.
L’approche décrite ici représente une trajectoire possible d’industrialisation du tracking.
Chaque organisation devra déterminer le niveau d’automatisation adapté à ses moyens, à ses compétences et à sa culture.
Conclusion : de la mesure déclarative à la mesure vérifiable
Le tracking a longtemps été considéré comme une couche technique ajoutée aux applications pour répondre aux besoins du marketing, de l’analytics et du pilotage de la performance.
Son intégration à la chaîne de production logicielle ouvre une autre perspective.
Le plan de marquage devient un contrat versionné. Les événements deviennent des comportements testables. Les règles de collecte deviennent des critères d’acceptation. Les configurations GTM peuvent devenir des ressources déployables automatiquement. Les pipelines CI/CD produisent des preuves de conformité.
Dans un environnement marqué par les déploiements continus, les expérimentations et le feature flipping, cette approche apporte également une réponse à la difficulté de maintenir les plans de marquage au rythme des évolutions applicatives.
L’agentique peut accélérer cette transformation en facilitant la traduction des besoins métier, la génération des tests, l’analyse des modifications et l’investigation des anomalies.
Le projet expérimental QOSA Tracking & CI vise à confronter cette approche aux contraintes concrètes de l’ingénierie logicielle, afin d’en mesurer progressivement la faisabilité, les bénéfices et les limites.
Mais la rupture principale réside ailleurs : **la qualité de la mesure cesse d’être une vérification périphérique pour devenir une exigence intégrée à la fabrication du logiciel.**
Cette évolution engage aussi une transformation des métiers.
À mesure que la production, la configuration et la fiabilisation des données deviennent des capacités intégrées aux produits logiciels, le rôle technique traditionnel du Digital Analyst pourrait être progressivement absorbé par les équipes de développement, de qualité et d’ingénierie des données.
Cette hypothèse laisse ouverte la question du maintien de l’expertise analytics transverse, de la gouvernance de la donnée et de la responsabilité des contrats de mesure.
Le Business Analyst, quant à lui, conserve sa place au cœur de la compréhension des enjeux économiques, de l’interprétation des résultats et de la décision.
La prochaine étape de maturité du digital analytics pourrait ainsi consister à industrialiser la mesure jusqu’à rendre son instrumentation transparente, pour concentrer la valeur humaine sur ce qui demeure essentiel : comprendre, décider et améliorer la performance.
Sources et lectures complémentaires
Tracking plan as code et contrats
- RudderStack : des contrats d’événements définis en YAML ou JSON, versionnés, revus par Pull Request et validés en CI. https://www.rudderstack.com/learn/data-strategy/tracking-plans-as-code/ rudderstack
- Snowplow : des contrôles du contrat en CI/CD et en production. https://snowplow.io/blog/why-data-contracts-are-obviously-a-good-idea snowplow
- Trackingplan, quatre approches de validation analytics : tests synthétiques planifiés, gouvernance du tracking plan, observabilité du trafic de production, qualité de données dans l’entrepôt. https://www.trackingplan.com/blog/analytics-validation-tools-compared trackingplan
- Trackingplan, analytics dans la CI : validation des spécifications contre une référence, avec un rapport utilisable comme erreur ou alerte dans le pipeline.
- https://www.trackingplan.com/blog/shifting-left-your-analytics-testing trackingplan
- Open Data Contract Standard (Bitol) : https://github.com/bitol-io/open-data-contract-standard
Tests Playwright sur dataLayer et GA4
- ScrollTest : intercepter, vérifier et simuler les balises analytics dans Playwright. https://scrolltest.com/playwright-analytics-event-verification/ scrolltest
- Playwright-BDD : vérifier automatiquement le dataLayer et l’exécuter dans la CI avec les tests fonctionnels. https://medium.com/@mbatra5/automating-datalayer-analytics-testing-with-playwright-bdd-ensuring-tracking-accuracy-at-scale-fc6103aea1fa medium
- Seek and Hit : un framework Playwright et TypeScript ciblant les événements GTM, avec validation des champs du dataLayer. https://seekandhit.com/engineering/valid-tracking-data-yes-please-pt-2/ seekandhit
GTM par API et infrastructure as code
- Earnst : un flux de déploiement par workspace avec résolution des conflits avant publication. https://www.earnst.io/en/knowledge/gtm-api-automation-infrastructure-as-code/ earnst
- S9 Consulting : cloner une configuration maître vers d’autres conteneurs via l’API GTM. https://www.s9-consulting.com/post/google-tag-manager-automation-guide s9-consulting
- Square, server-side GTM sur Cloud Run : Terraform pour appliquer les changements sur tous les environnements et suivre les versions avec git. https://developer.squareup.com/blog/deploying-server-side-google-tag-manager-on-cloud-run/ squareup
- Un provider Terraform existe déjà : il gère comptes, conteneurs, workspaces, balises, déclencheurs, variables et versions GTM. https://github.com/1keiuu/terraform-provider-google-tag-manager github
IA et rôle de l’analyste
- Paradigma Digital : comment le rôle du Digital Analyst est redéfini avec les agents analytics. https://paradigma-digital.medium.com/analytics-with-ai-agents-what-if-the-next-report-is-more-than-just-a-report-af0fa7d336c5 medium
- Databricks : le rôle de l’analyste se déplace vers le cadrage des problèmes, le contexte organisationnel et la traduction des résultats en décisions. https://www.databricks.com/blog/future-data-analytics-why-ai-rewriting-analysts-job-description